Fire dage. Tre cases. Solo.
I en weekend i september stillede jeg op alene i Nordic AI Cup mod erfarne hold fra hele Norden. Det her er historien om tre vidt forskellige AI-opgaver, om det, der gik galt, og om det, jeg tager med videre.
Hvad er Nordic AI Cup?
Konkurrencen startede som DM i AI i 2021, skabt af den danske virksomhed Ambolt AI for at finde og udvikle den næste generation af AI-talenter. I 2026 blev den nordisk: Danmark, Norge, Sverige, Finland og Island konkurrerede samtidig, online, over fire dage.
Formatet er enkelt og hårdt. Man får en række cases fra virkelige problemstillinger og skal bygge en AI-løsning, der bliver evalueret på arrangørernes egne maskiner og data. Det er ikke nok, at det virker hjemme hos dig selv. Det skal virke derude.
Jeg deltog solo. Det betød, at jeg selv skulle dække tre helt forskellige discipliner på én gang: reinforcement learning, computer vision i realtid og tale- og sprog-AI i sundhedssektoren.
Den røde tråd i hele weekenden var forskellen på “det virker i mine egne tests” og “det virker på den maskine, det reelt bliver evalueret på”.
Survival Simulator
OpgavetekstenSurvive harsh wilderness conditions by building an agent that adapts.
En art af agenter skulle lære at overleve fra bunden, uden at nogen fortalte dem hvordan.
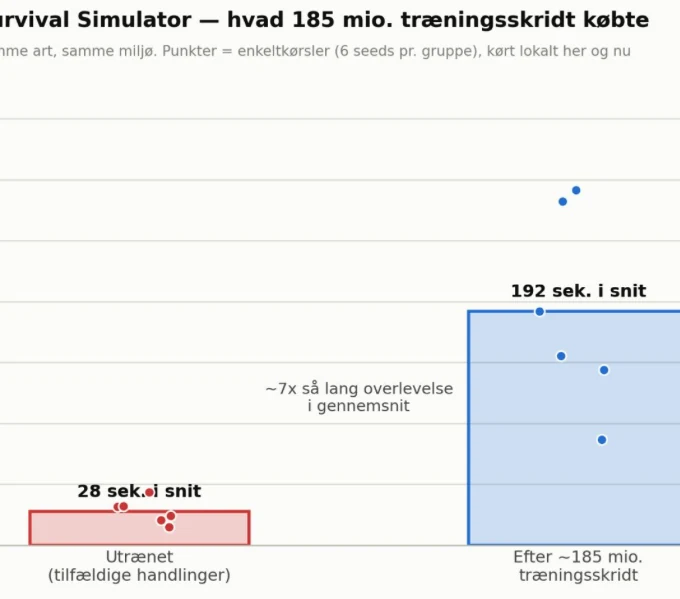
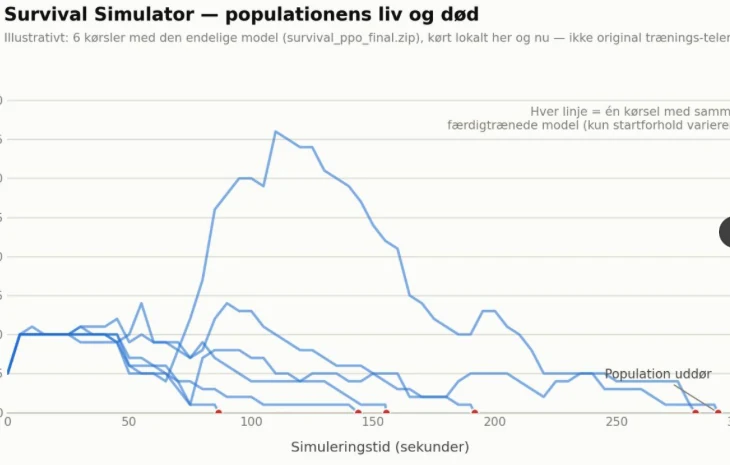
Opgaven var at bygge en agent, der kan klare sig i en barsk, simuleret vildmark. Der var ingen regler at følge, kun en belønning for at holde sig i live. Med tilfældige handlinger uddøde arten efter under 30 sekunder.
Jeg trænede arten med reinforcement learning i ca. 185 millioner træningsskridt på universitetets supercomputer. Det var her, det for alvor blev sjovt.
Det største gennembrud kom, da jeg fandt ud af, at hver agent skulle belønnes individuelt for at turde formere sig. Når belønningen kun gjaldt for arten samlet, druknede det vigtigste signal i støj.
Det lærte jegHvordan man belønner, betyder lige så meget som hvor længe man træner.
Drone Flyby
OpgavetekstenDetect objects in a drone sequence and steer the camera’s zoom level to find the detail you need.
Find objekterne i en dronevideo, og styr kameraets zoom, så du ser den detalje, der betyder noget.
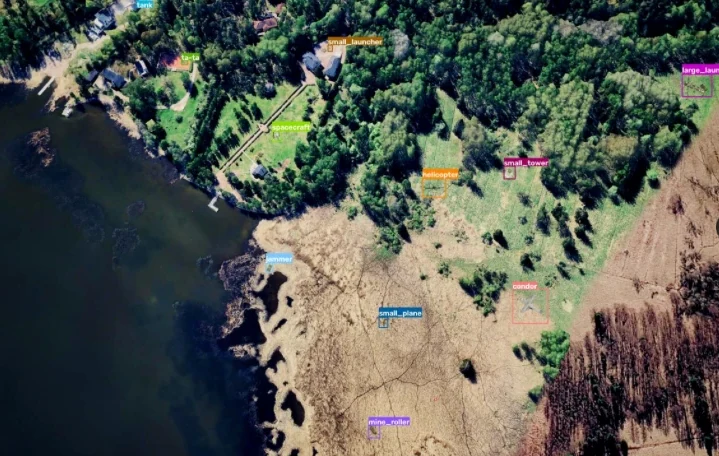
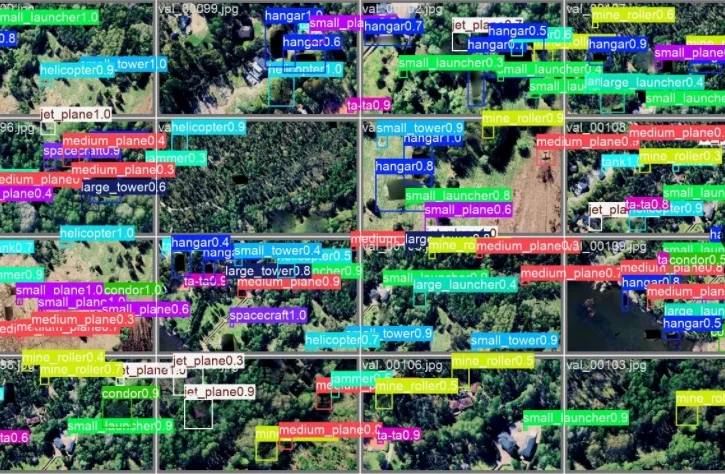
Opgaven var objektgenkendelse i realtid: en drone flyver hen over et landskab, og modellen skal finde og markere objekterne og samtidig styre kameraets zoom.
Her lærte jeg, hvor let man snyder sig selv. Min model scorede flot i mine egne tests, men den havde reelt bare lært de 25 træningsbilleder udenad. Første gang den mødte en ukendt scene, styrtdykkede scoren.
Løsningen blev at generere hundredvis af syntetiske variationer af billederne med en diffusionsmodel, indtil modellen faktisk lærte at genkende og ikke bare huske.
Det lærte jegEn høj score på egne data betyder ingenting, før modellen har mødt noget, den ikke har set før.
Medical Appointment
OpgavetekstenListen to recorded medical appointments and figure out what was actually said between clinician and patient.
Lyt til optagede lægesamtaler, og find ud af, hvad der faktisk blev sagt mellem læge og patient.
Systemet skulle lytte til læge-patient-samtaler, svare på 10 spørgsmål pr. samtale og pege præcist på, hvor i lyden beviset for svaret findes.
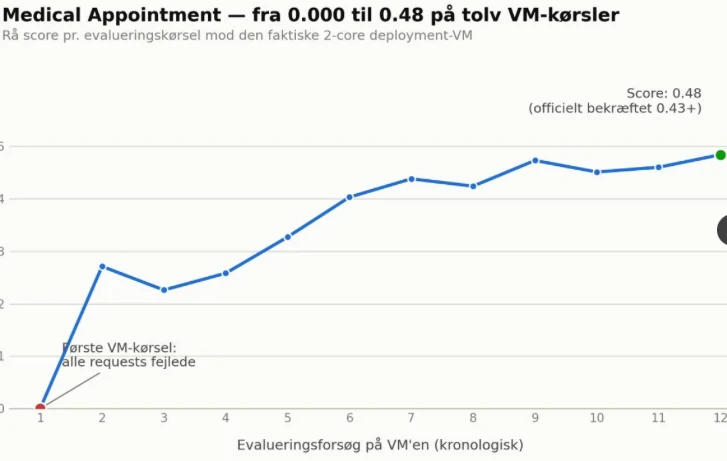
Første kørsel på den rigtige evalueringsmaskine, en server med kun to kerner, fejlede på hver eneste forespørgsel. Scoren var 0. Det, der virkede på min egen computer, skulle bygges om, så det kunne køre stabilt derude.
Over tolv evalueringskørsler kravlede scoren op til 0,48, og systemet endte med op mod 80 % rigtige svar. Det blev min stærkeste case.
Det lærte jegDer ligger mange lag infrastruktur mellem en model, der virker, og et system, der virker.
Noget, der virkede. På alle tre.
Første gang jeg var med til den slags, med tre vidt forskellige AI-discipliner på én gang og mod erfarne hold fra hele Norden. Jeg er stolt af at have leveret noget, der rent faktisk virkede, på alle tre.
Det største, jeg tager med, er en langt bedre fornemmelse for, hvor mange lag infrastruktur der ligger mellem “det virker hos mig” og “det virker, når det bliver evalueret”. Og Drone Flyby blev en god forsmag på object detection, som jeg nu bruger direkte i vores semesterprojekt om dronedetektion.
Tak til Ambolt AI for at stable konkurrencen på benene, og til DDSA, The Danish Data Science Academy, og Pioneer Centre for AI for at gøre det muligt i Danmark.
Lad os tage en snak.
Praktik, et projekt, et samarbejde eller bare en kop kaffe om AI. Skriv til mig.